2026 年抓取 X 数据比几年前难得多。未登录访问基本关闭,X 的条款禁止未经同意的抓取,流行的开源爬虫要么失效,要么需要真实的 X 账号才能运行。如果放慢速度、遵守规则,小规模采集公开数据仍然可行。但只要是定期或大规模的需求,用 API 通常更省事。
我们运营 TwittrAPI,一个提供 X 公开数据的第三方 API,所以上面后半句话和我们有利益关系。下文的事实来自 X 自己的页面、法院相关报道和各爬虫项目的代码仓库,均列在“参考来源”中,并于 2026-10-10 核对。以下内容不构成法律意见。
X 的规则怎么规定数据抓取
服务条款禁止未经同意的抓取
X 的服务条款(2026 年 10 月 9 日生效的版本)规定,除非与 X 另有协议,否则不得通过 X 公开提供的接口以外的任何方式访问、爬取或搜索其服务。条款中的注释还写明,未经事先书面同意,任何形式的爬取或抓取都被明确禁止。
条款中还有一条约定违约金条款:任何人违反条款或协助他人违反条款,并在任意 24 小时内请求、查看或访问超过 1,000,000 条帖子,需按每 1,000,000 条帖子 US$15,000 承担赔偿。欧盟版本以欧元标价。据 Knight First Amendment Institute 介绍,该条款首次出现在 2024 年 11 月 15 日生效的条款中。
robots.txt 默认屏蔽所有爬虫
x.com/robots.txt 对 User-agent: * 禁止抓取所有内容。特定的搜索引擎爬虫有单独的规则:Googlebot 和 Bingbot 可以抓取大部分页面,但不能抓取粉丝、关注、点赞和搜索页面。多个 AI 和社交平台的爬虫被完全屏蔽。一个遵守 robots.txt 的爬虫在 X 上没有任何内容可抓。
推特爬虫为什么会被封
2023 年的三项变化让大部分未登录抓取失效,而且至今没有任何一项朝着对爬虫有利的方向改回来。
登录墙。 2023 年 6 月底,Twitter 开始向未登录访客显示登录提示,而不是帖子内容,TechCrunch 对此做了报道。
按账号限制读取量。 2023 年 7 月 1 日,埃隆·马斯克宣布限制每个账号每天可读取的帖子数:认证账号 6,000 条,未认证账号 600 条,新注册的未认证账号 300 条。同一天他又将上限提高到 10,000、1,000 和 500 条。他将原因归咎于“极端程度的数据抓取”(出处同上)。正因为有这类限制,基于账号的爬虫才会把请求分散到大量账号上。
取消访客访问。 广泛使用的 snscrape 依赖未登录访问。它的 issue “All Twitter scrapes are failing: blocked (404)”于 2023 年 6 月 30 日提出,至今仍处于打开和置顶状态。
哪些方法还能用,代价是什么
基于账号的爬虫
twscrape 等工具通过已登录的 X 账号仍然可用。它的 README 说明需要已授权的账号,可以用 cookie(auth_token 和 ct0)或账号登录。它按账号和接口跟踪速率限制,一个账号的额度用完就切换到另一个账号。README 还提到,用户时间线最多只能获取约 3,200 条推文。
这套方案能用,但有代价:
- 你需要 X 账号,抓取是以这些账号的名义进行的,上述条款同样适用于这些账号。
- 所有限制都按账号计算,所以吞吐量取决于你运行多少个账号。
- X 的内部接口不是公开接口。一旦接口变动,工具就会失效,直到有人修复。
浏览器自动化
用 Playwright 或 Selenium 驱动真实浏览器,能拿到已登录用户能看到的内容,速度也和普通用户差不多。它会遇到同样的登录墙、同样的单账号读取限制和同样的条款,而且运行慢、资源占用大。
本文不涉及的内容
很多 X 抓取教程接下来会讲轮换代理、伪造浏览器指纹和破解验证码。这些手段的目的是绕过 X 的管控,而这正是条款所禁止的;这也是一场需要持续投入维护成本的对抗。本文不涉及这些内容。
如何抓取而不被封
如果你仍然要小规模抓取,以下几点可以帮你避开大部分麻烦:
- 规模小,速度慢。 以正常人的速度读取几百条帖子,和每小时抓取几百万条完全是两回事。US$15,000 的赔偿条款从 24 小时内超过 1,000,000 条帖子开始适用。
- 只抓公开数据。 不要采集受保护账号、私信,或任何你没有被授权登录才能看到的内容。
- 全部缓存。 同一天内不要重复获取同一个用户资料或同一条帖子。
- 遇到错误就停。 出现 429、登录提示或空白页面,意味着应该放慢或停止,而不是加大重试力度。
- 了解你所在地的法律。 采集个人数据有其自身的法律规定,与 X 的条款无关。
美国的法律情况
讨论数据抓取时,总会提到两个案例。但它们都不能直接回答你的项目是否合法。
hiQ Labs v. LinkedIn。 2022 年 4 月,美国第九巡回上诉法院再次认定,抓取公开可访问的页面很可能不构成《计算机欺诈和滥用法》(CFAA)所说的“未经授权”访问,即使在收到停止侵权通知函之后也是如此(Fenwick 摘要)。该判决不涵盖登录后才能看到的数据,也不涉及违约或违反服务条款的主张、版权或侵入财产的主张。
X Corp. v. Bright Data。 2024 年 5 月,William Alsup 法官驳回了 X 对数据公司 Bright Data 的起诉。X 没有主张抓取造成了损害,而它关于出售公开帖子的主张被版权法优先适用排除(MediaPost)。2024 年 11 月,他允许 X 重新提出抓取损害其服务器的主张(MediaPost)。双方于 2025 年 6 月和解,条款保密(Bloomberg Law)。
简单来说:在美国,抓取公开页面并不自动构成犯罪,但基于服务条款的违约主张仍有可能,而且条款现在已经写明了价格。
什么时候改用 API:Twitter 爬虫的替代方案
符合以下任一情况时,建议使用 API:
- 你需要每天获取数据,而不是只抓一次。
- 你需要超过几千条帖子或用户资料。
- 你不想管理 X 账号、会话和各种失效问题。
- 其他人(客户、合规团队)需要知道数据的来源。
API 分两类。
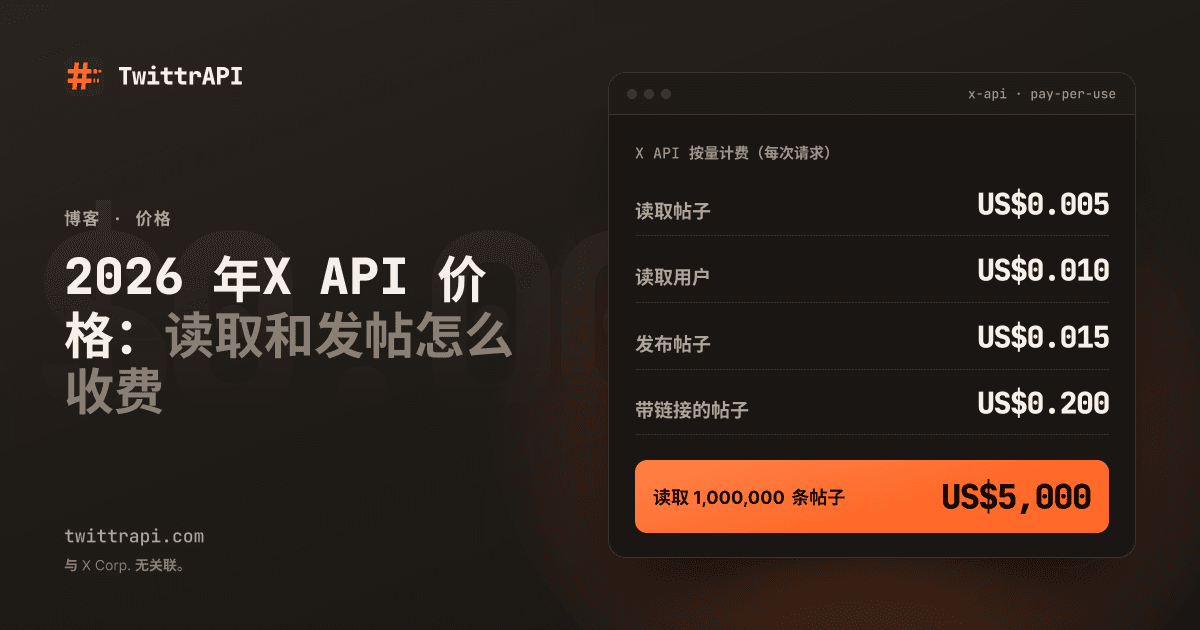
X 官方 API。 在 console.x.com 注册,按量付费:读取帖子每条 US$0.005,读取用户每个 US$0.010,按量付费每月最多读取 300 万条帖子。这是 X 唯一支持的途径,也是发帖或代表用户操作的唯一途径。详见 2026 年 X API 价格,请求限制见 Twitter API rate limits explained(英文)。
提供公开数据的第三方 API。 TwittrAPI、twitterapi.io 和 SocialData 等服务商自行负责采集,并通过自己的 REST 接口和密钥出售公开数据的访问权限。你不需要 X 开发者账号、X 账号或抓取基础设施。它们与 X 无关联,只返回公开数据,你也应该确认使用它们是否符合你自己的合规要求。各家公布的价格对比见 the cheapest Twitter API in 2026(英文)。
| 自己抓取 | X 官方 API | 第三方 API | |
|---|---|---|---|
| X 的条款 | 未经同意禁止 | 允许 | 视服务商和你的用途而定 |
| 准备工作 | 账号、会话、工具 | 开发者账号、应用、额度 | 服务商账号、密钥 |
| X 改动后是否失效 | 会,需要你自己修 | X 会公告变更 | 由服务商修复 |
| 读取公开数据的成本 | 你的时间和基础设施 | 每 1,000 条帖子 US$5 | 每 1,000 次调用或每 1,000 条几美分 |
| 发帖 | 本文不涉及 | 支持 | 请使用官方 API |
使用 TwittrAPI 时,一次请求就是一次带密钥请求头的 HTTP 调用。文档(英文)列出了请求示例,价格页面显示每 1,000 次调用 US$0.065 起,在开始使用页面可以获取一个带 US$0.10 测试额度的密钥。具体步骤见 how to get an X API key without a developer account(英文)。
常见问题
抓取推特(X)数据合法吗?
这取决于你采集什么、怎么采集以及你身在何处。X 的条款禁止未经书面同意的抓取,并对 24 小时内超过 1,000,000 条帖子的情况规定了违约金。在美国,hiQ v. LinkedIn 判决认为抓取公开页面很可能不构成 CFAA 下的犯罪,但这并不排除违约主张。个人研究以外的用途,请咨询法律意见。
不登录能抓取推特数据吗?
几乎不能。自 2023 年年中起,X 向未登录访客显示登录提示,robots.txt 也禁止所有未被特别允许的爬虫。snscrape 等依赖未登录访问的工具从 2023 年 6 月起一直无法使用。
snscrape 还能抓取推特吗?
不能抓取推特。snscrape 中报告所有 Twitter 抓取均失败的 issue 于 2023 年 6 月 30 日提出,至今仍未关闭。
获取推特数据最稳妥的方式是什么?
X 官方 API 是 X 支持的途径。如果想以更低成本读取公开数据,第三方 API 可以省去抓取所需的账号和维护工作。无论哪种方式,只采集你需要的数据,并确认适用于你的规则。
参考来源
- X 服务条款
- x.com robots.txt
- Knight First Amendment Institute 对 X 2024 年 11 月条款的评论
- TechCrunch:Twitter 限制用户可读取的推文数量(2023 年 7 月 1 日)
- snscrape issue #996:All Twitter scrapes are failing
- GitHub 上的 twscrape
- Fenwick:hiQ Labs v. LinkedIn,第九巡回上诉法院(2022)
- MediaPost:法官驳回 X 对 Bright Data 的起诉(2024 年 5 月)
- MediaPost:X 可重新提出对 Bright Data 的抓取主张(2024 年 11 月)
- Bloomberg Law:X 与 Bright Data 就抓取纠纷达成和解(2025 年 6 月)
- X API 价格(docs.x.com)